
浏览器全网搜索
将以下提示词粘贴到你的 AI 对话框中:
请根据 https://skillhub.cn/install/skillhub.md,安装 @user_2c495456/browser-web-search。
技能介绍
问题
Browser Web Search 要解决的是:AI Agent 想从多个网站检索内容时,每个站点的接口、登录态和返回结构都不统一,直接抓取既脆弱又难解析,也难以把结果稳定地喂给模型做后续判断。
工作方式
它把 55 个平台封装成统一的命令行搜索接口,无需 API Key,输出结构化 JSON,并支持 --jq 和 --count 在源头过滤字段。公开站点可直接查询,命令覆盖搜索、热榜、详情、评论、历史等动作,例如今日头条、知乎、GitHub、Hacker News、arXiv 等。微信、小红书、微博、豆瓣、X、LinkedIn 等站点可复用已登录浏览器会话,但默认按敏感 adapter 拒绝,需要显式授权后才允许访问账户相关、评论、历史或用户动态类接口。
适用边界
它适合给 Agent 增加跨站点检索能力,尤其适合公开信息、社区热榜、开发者资源、论文和产品数据库查询。使用前应区分公开接口与敏感接口,先用 --jq 减少字段,再决定是否允许访问账户数据。注意第三方包会在浏览器标签页上下文执行 JS,理论上可读取当前会话可见数据;建议使用独立浏览器 profile、固定版本、保留审计日志,不要把完整响应直接外发。
使用场景
- 为调研 AI Agent 竞品,同时在知乎、掘金、Product Hunt 搜索相关文章并输出 JSON 摘要
- 监控 Hacker News、Reddit、V2EX 的 LLM 讨论热榜,用 `--count` 取前 10 条
- 抓取 arXiv、GitHub、Stack Overflow 的 ai search 相关资料,用 `--jq` 只保留标题和链接
- 查询豆瓣、IMDb 的 Top250 电影,并筛选出评分、年份和类型字段
适合人员
- 做竞品调研的分析师,需要从知乎、微博、小红书等多平台抽取同一话题内容
- 构建搜索工具的工程师,要把多个站点结果转成统一 JSON 供模型调用
- 做技术情报的编辑,要批量抓取 Hacker News、GitHub、arXiv 的最新条目
- 需要影视资料的研究人员,要查询豆瓣、IMDb 的评分榜单并筛选字段
相关技能
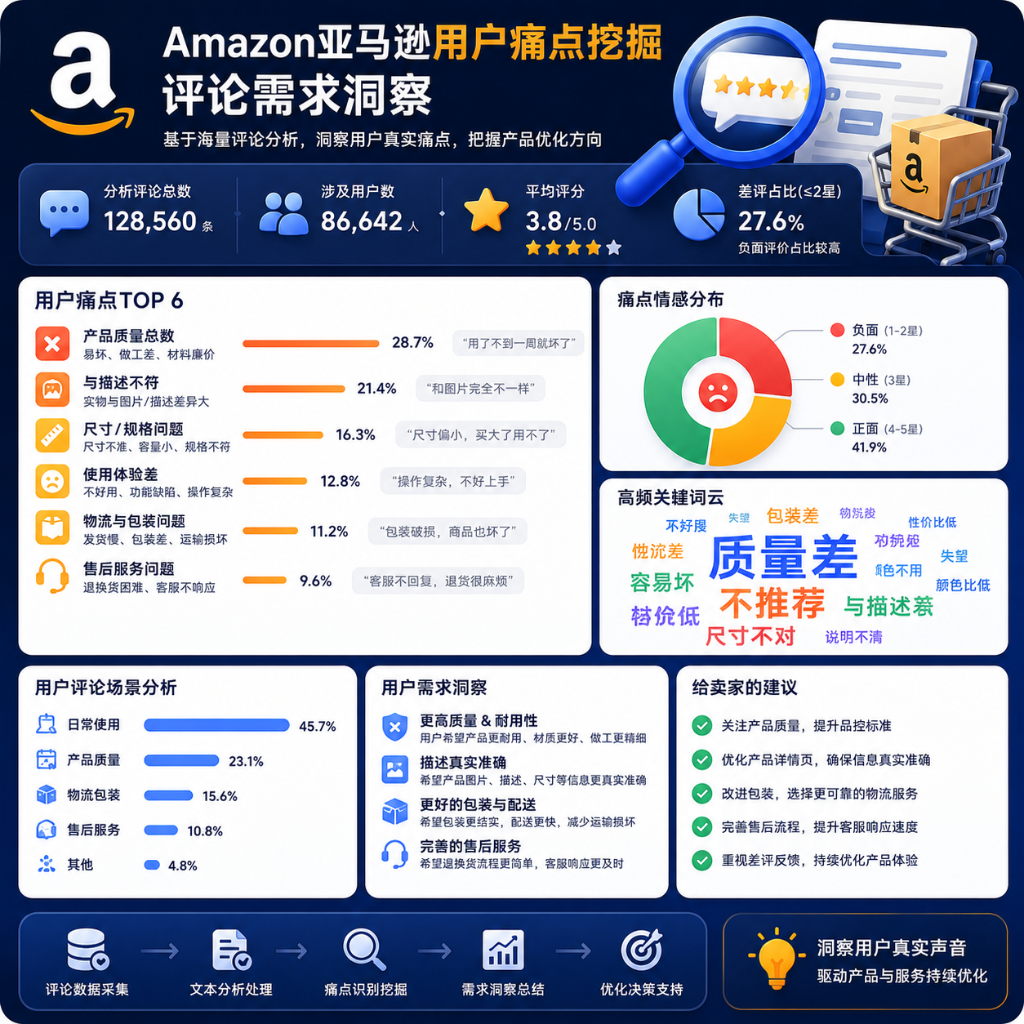
亚马逊用户痛点挖掘与评论需求洞察
@user_507a5056/pain-point
基于 ARI 评论样本分析 Amazon 用户痛点、VOC 报告、差评预警与竞品对比,辅助需求洞察和经营决策。
数据分析
2026.08.30
↓ 365

百度热搜榜 TOP 10
@user_512254e3/top-baidu-hot
优先使用 web_fetch 抓取百度热搜,校验当天数据,失败时自动降级到浏览器,并输出 TOP 10 排名标题。
数据分析
2026.08.29
↓ 389

A股政策与交易机会日报
@user_1c63be68/a-stock-daily-report-plus
每晚自动搜集指数、政策与资金数据,按固定模板生成约1200字的A股政策与交易机会日报,并标注受益板块、驱动事件和涨跌方向。
数据分析
2026.08.29
↓ 389
TikTok KeyAPI 内容分析
@user_2e47cd26/keyapi-tiktok-content-analysis
将自然语言 TikTok 需求映射到 KeyAPI REST 场景,按文档校验端点并执行数据查询与分析。
数据分析
2026.08.29
↓ 394