
智能网页爬虫
将以下提示词粘贴到你的 AI 对话框中:
请根据 https://skillhub.cn/install/skillhub.md,安装 @user_15292d5a/yjkj-smart-scraper-web。
技能介绍
问题
网页抓取工具通常只返回原始 HTML,agent 还需要手工挑出 title、表格、价格、列表和正文。页面内容分散,结构不统一,反复请求同一页面也会带来额外延迟。
工作方式
smart-scraper-web 用 Node.js http/https 获取页面,并用带边界限制的 regex 做解析,输出结构化数据而不是整段 HTML。核心模式包括:--extract 抓全量标题、段落、链接、图片、表格、列表、价格和 metadata;--table / --list / --price 定向抽取;--article 聚焦标题与段落;--parse 解析已有 HTML;--status 查看缓存。页面缓存存在 memory/scraper-cache/cache.json,默认 5 分钟 TTL,LRU 限制 50 条或 10MB。安全上只允许公共 http/https,拦截 file://、data:、gopher://、localhost、私网 IP 和云元数据地址,并对重定向目标再次校验,最多 5 次重定向。
适用边界
它不是 DOM parser,也不执行 JavaScript,所以 SPA 动态内容、依赖前端渲染的数据不适合。价格识别基于 regex,能识别 $、€、£、¥ 与千分位格式,但不做语义判断。单次请求 15 秒超时,最小请求间隔 100ms。敏感页面使用后建议删除 cache.json。
使用场景
- 从公开费率表中提取行列表格,用于生成竞品服务对比清单。
- 在商品页中抽取标题、价格和图片 alt 文本,形成基础比价数据。
- 抓取技术文档页的标题层级和前段正文,生成摘要卡片。
- 解析已抓取的 HTML 中的有序列表和无序列表,输出菜单结构。
适合人员
- 做市场监测的分析师:需要从公开网页表格和价格文本中拿到可整理字段。
- 搭建 agent 工具链的软件工程师:需要把抓取结果转成结构化 JSON 供模型使用。
- 做内容聚合的编辑:需要从文档页提取标题层级与正文预览。
- 处理历史网页快照的数据工程师:需要离线解析已有 HTML 中的列表和表格。
相关技能
基于五步框架搜索近期数据,快速分析公司需求、商业模式、护城河、生命周期与外部环境,并生成 HTML 可视化报告。

结合 DCF 估值、Livermore 趋势规则与市场情绪指标,生成 A 股/港股买入信号和完整分析报告。
面向工程师的统计分析技能,覆盖假设检验、回归、相关、贝叶斯分析、假设检查、效应量与 APA 报告。
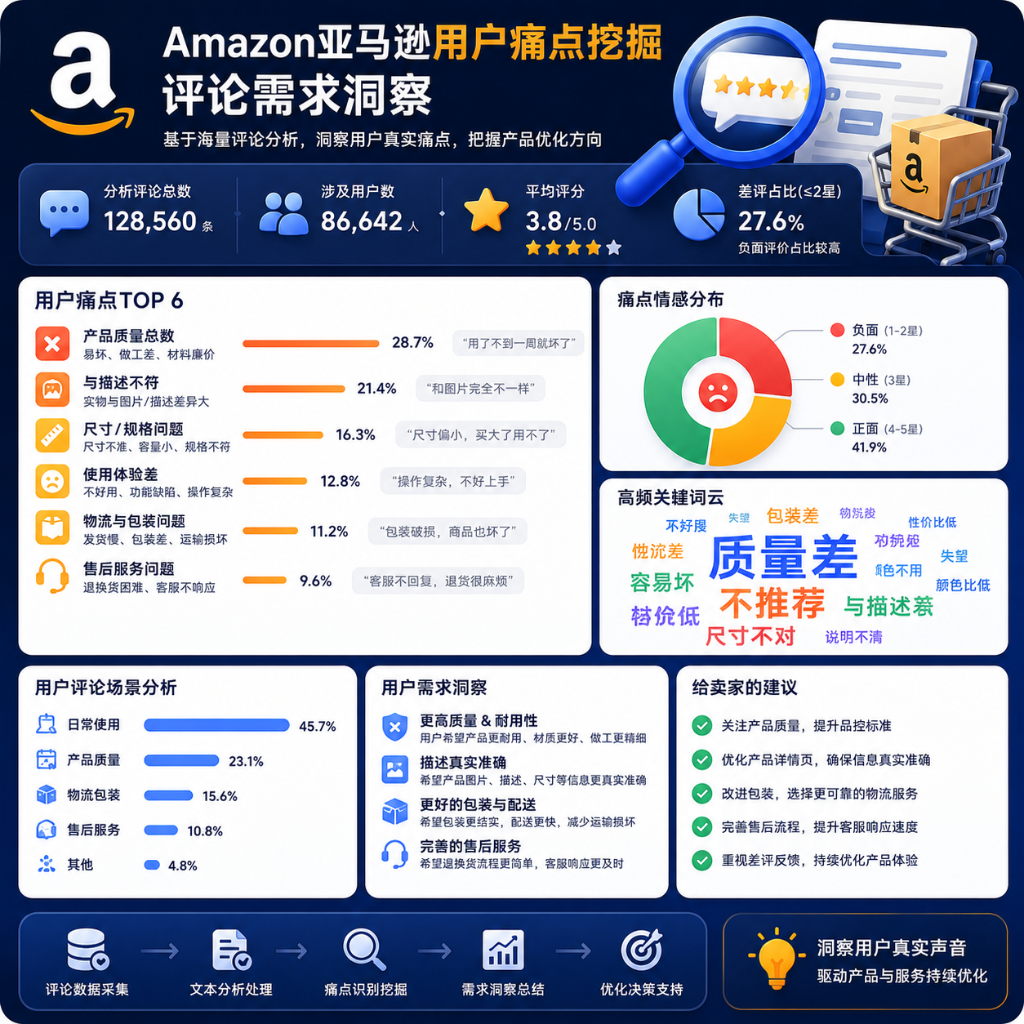
基于 ARI 评论样本分析 Amazon 用户痛点、VOC 报告、差评预警与竞品对比,辅助需求洞察和经营决策。