
公众号文章 Markdown 抓取器
将以下提示词粘贴到你的 AI 对话框中:
请在 AI 助手中根据 https://skillhub.cn/install/skillhub.md,安装 @user_5223609c/scrapling-article-fetch。
技能介绍
问题
公众号文章在浏览器里可读,但正文常嵌在微信页面结构里,直接保存网页会混入扫码提示、授权弹窗、侧边栏等噪音;若要把正文用于整理、校对或二次编辑,还需要把 HTML 稳定转成 Markdown,并尽量保留链接与图片。
工作方式
该技能面向 mp.weixin.qq.com 做正文抽取:先检查 Python 3.10+ 环境,再用 scrapling_fetch.py 拉取页面,优先尝试 #js_content、.rich_media_content 等容器;未命中时回退到 article、main 等通用选择器,最后用 html2text 输出 Markdown。结果默认保留链接与图片,清理微信尾部噪音,并按 max_chars 截断,适合逐段对照原文验收。
需要写入飞书时,调用 md_to_feishu_doc.py,传抓取产出的 .json 路径读取标题,而不是让模型自行概括标题。脚本以当前 agent 身份直连 Feishu OpenAPI,可按 user_open_id 补编辑权限,也可传 doc_id 覆盖更新已有文档。非飞书场景则直接以 Markdown 回复正文、标题和原文链接。
注意点
它依赖稳定 Python 环境与可访问目标 URL;若页面强依赖 JS 导致正文为空,需改用动态抓取变体。飞书写入不负责补抓封面,封面缺失应回到上游抓取阶段处理。
使用场景
- 把 mp.weixin.qq.com 的文章正文抽成 Markdown,保留链接和图片,用于校对。
- 在飞书渠道把抓取结果写入飞书文档,并用 user_open_id 给自己加编辑权限。
- 将公众号长文按 max_chars 截断成可审阅摘要,再与原网页逐段对照。
- 在非飞书聊天里直接输出标题、原文链接和完整正文,而不只给链接。
适合人员
- 维护知识库的工程师,需要把微信文章转成可版本化 Markdown。
- 运营人员,需要在飞书里创建可编辑文档验收公众号内容。
- 研究员,需要提取公众号正文并保留链接图片做资料整理。
- 自动化流程维护者,需要按固定 JSON/Markdown 输出对接后续流程。
相关技能

基于五步框架搜索近期数据,快速分析公司需求、商业模式、护城河、生命周期与外部环境,并生成 HTML 可视化报告。

结合 DCF 估值、Livermore 趋势规则与市场情绪指标,生成 A 股/港股买入信号和完整分析报告。
面向工程师的统计分析技能,覆盖假设检验、回归、相关、贝叶斯分析、假设检查、效应量与 APA 报告。
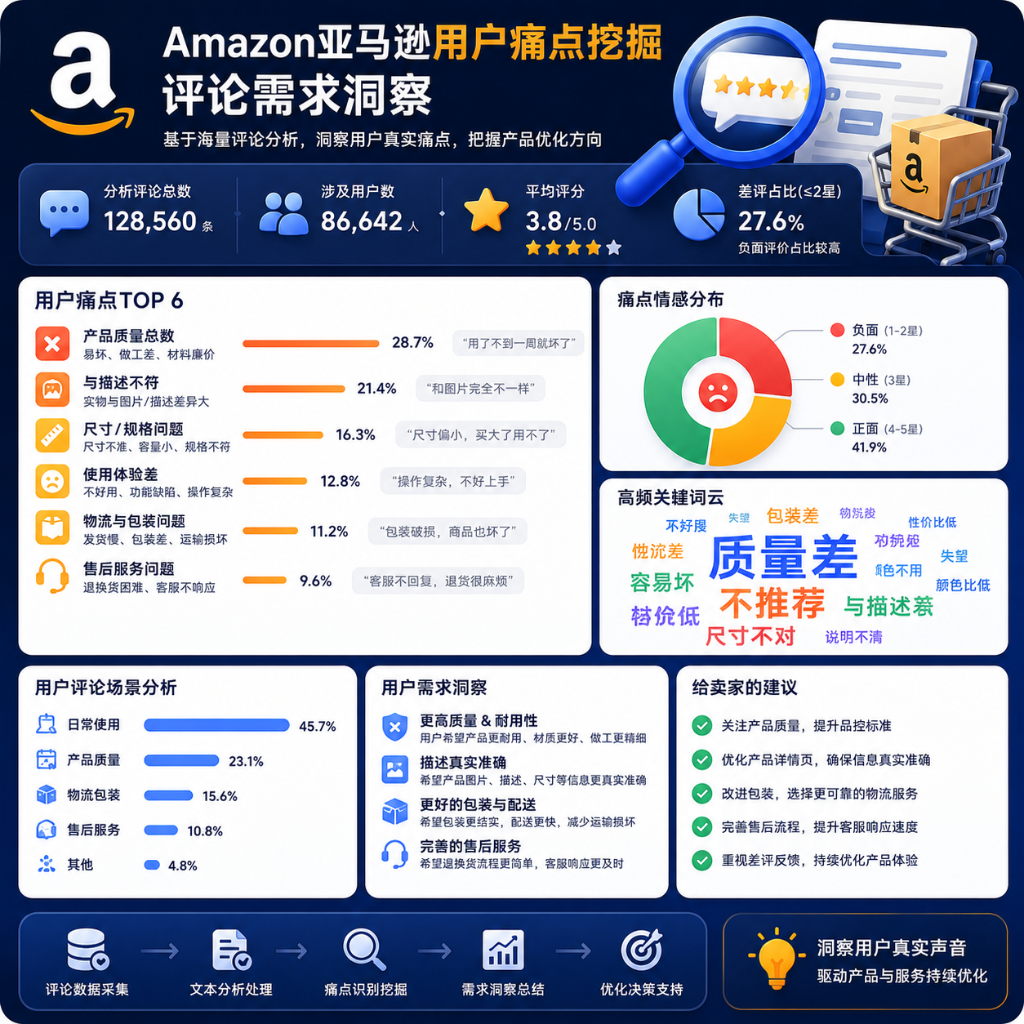
基于 ARI 评论样本分析 Amazon 用户痛点、VOC 报告、差评预警与竞品对比,辅助需求洞察和经营决策。