小红书笔记提取器
将以下提示词粘贴到你的 AI 对话框中:
请根据 https://skillhub.cn/install/skillhub.md,将 @user_ae1514da/rednote-extract 安装到 AI 助手中。
技能介绍
小红书内容结构化抓取的痛点
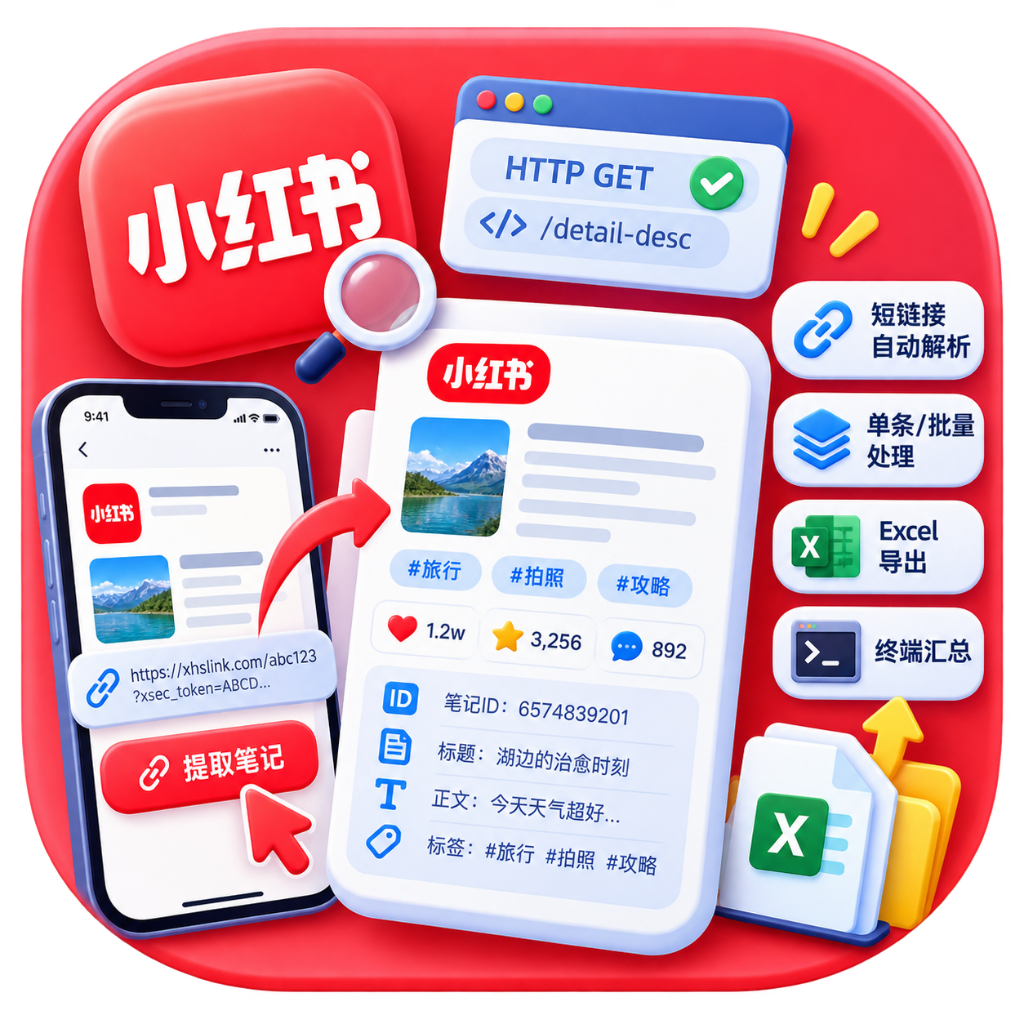
在内容运营和数据分析场景中,经常需要将小红书分享链接转化为结构化数据进行二次处理。手动复制不仅效率低下,难以处理批量任务,且难以保证字段的准确性与一致性。该技能旨在通过自动化手段解决这一难题,直接从分享链接中解析并重组笔记的核心文本单元。
核心运行原理与工作流
该技能的核心机制基于对小红书分享页 HTML 结构的解析。当脚本接收到包含 xsec_token 的分享链接时,会直接发起 HTTP GET 请求获取完整 HTML 页面。
- DOM 节点定位:核心逻辑聚焦于解析源码中
id="detail-desc"的div容器,该节点承载了笔记的全部文字内容。 - 字段精细化拆采:
- note_id:提取页面中的 24 位十六进制唯一标识符。
- title 与 content:智能识别并切割标题与正文,妥善处理以 # 开头的纯标签笔记场景。
- tags:提取话题标签列表,并自动执行“去重保序”操作。
- 产物格式化输出:支持生成 JSON、CSV、XLSX 或人类可读的文本摘要,满足从数据管道导入到直接报告生成的不同需求。
适用边界与工程注意事项
虽然基础提取仅需 Python 标准库,但在工程化落地时需注意以下约束:
- 依赖配置:若需导出 XLSX 格式(如生成包含“汇总统计”和“提取结果”的双 Sheet Excel),必须提前安装
openpyxl库。 - Token 时效性与风控:
xsec_token是动态生成的参数,一旦过期或失效,目标页面将无法渲染出detail-desc节点。批量处理时需关注 0.5 秒的默认请求间隔,以避免触发平台风控。
使用场景
- 运营收集了上百个竞品小红书笔记链接,需要批量转化为包含标题和正文的 Excel 表格,用于内容分析。
- 社区审核团队需要对用户提交的违规小红书笔记链接进行内容复核,通过脚本提取正文和标签以便快速定位敏感词。
- 开发人员正在搭建内容聚合 API,需要编写脚本将前端传来的小红书分享链接解析为 JSON 格式的结构化字段。
适合人员
- 负责竞品分析的运营专员,典型诉求是从大量竞品笔记链接中快速提取正文和标签,建立内容素材库。
- 负责社区风控的审核工程师,典型诉求是自动化提取待审核笔记的文本内容,配合敏感词库进行违规判定。
- 搭建数据采集管道的后端开发者,典型诉求是将非结构化的小红书分享链接转化为标准化的 JSON 或 CSV 数据存入数据库。
相关技能

微信聊天分析及预测工具
@user_9d5a2a39/wechatanalyzer
一款完全本地运行的微信聊天数据分析工具,支持MBTI人格推断、情感分析、风险检测、关系健康度评估和对话预测,注重隐私保护。
数据分析
2026.08.30
↓ 13488
BrowserSkill 浏览器自启动器
@user_656c2e70/bsk-browser-launcher
一个自动启动 Edge 浏览器并连接 BrowserSkill 扩展的通用组件,确保网页抓取和自动化任务的前置条件就绪。
数据分析
2026.08.30
↓ 4500
小红书笔记分析工作室
@beatra-ai/xiaohongshu-note-research
面向小红书单篇笔记或品类搜索,输出标题套路、结构、原话评论和可跟进角度的调研备忘;粘贴笔记即可无需查询完成,公开查询需单独确认且计费。
数据分析
2026.08.30
↓ 1818

股票交易监测系统
@user_62138798/stock-price-monitor
基于新浪财经接口的 A 股实时行情监测工具,支持价格与涨跌幅预警、日志记录和定时检查。
数据分析
2026.08.30
↓ 1180