
大数据管理与应用
将以下提示词粘贴到你的 AI 对话框中:
请根据 https://skillhub.cn/install/skillhub.md,安装 @user_a045eab5/bigdata-management。
技能介绍
要解决的问题
当需求提到实时看板、数据湖迁移、Spark 调优,但缺少数据量、延迟、团队栈时,方案容易停在工具堆砌。该技能先把输入约束清楚:业务场景、关注环节、技术栈偏好、问题是理论、实现还是方案设计。
工作方式与边界
- 采集与存储:覆盖
Kafka、Flume、DataX、HDFS、Ceph、Iceberg、Hudi、Delta Lake 等组件取舍。 - 处理与查询:围绕 Spark、Flink、Kafka Streams、Airflow、ClickHouse、Doris、Trino、Druid 给出批流、调度与 OLAP 思路。
- 治理与安全:结合 Atlas、DataHub、Great Expectations、Ranger 等讨论目录、血缘、质量和权限。
它要求输出可执行建议:架构取舍、工具对比、关键参数、文本流程图和必要代码示例。边界:更偏方案设计与工程咨询,不替代压测、上线、运维和成本核算;遇到新兴组件或私有实现,需回查官方文档和社区案例。
使用场景
- 设计日均十亿级日志的实时分析链路,确定 Kafka、Flink 与 OLAP 引擎分工。
- 把传统 Hive 数据仓库迁往 Iceberg 或 Hudi 数据湖,并制定分阶段迁移与回退方案。
- 排查 Spark SQL 任务慢、shuffle 高或数据倾斜,输出分区、内存与参数调优清单。
- 为风控推荐场景建立数据质量校验与血缘追踪,覆盖表结构、指标口径和访问权限。
适合人员
- 负责实时数仓选型的后端工程师,需要确定 Kafka、Flink、ClickHouse 或 Doris 的组合。
- 做数据平台治理的数据工程师,需要整理数据目录、血缘、质量规则与权限策略。
- 主导数仓到湖仓迁移的架构师,需要比较 Iceberg、Hudi、Delta Lake 并制定迁移路线。
- 分析 Spark 作业性能的开发同学,需要定位 shuffle、分区、内存与倾斜问题。
相关技能

快速搞懂一家公司
@user_2d8804af/gzh-skill-ca
基于五步框架搜索近期数据,快速分析公司需求、商业模式、护城河、生命周期与外部环境,并生成 HTML 可视化报告。
数据分析
2026.08.29
↓ 385

三因素A股港股综合分析
@user_231765ee/threefactor1
结合 DCF 估值、Livermore 趋势规则与市场情绪指标,生成 A 股/港股买入信号和完整分析报告。
数据分析
2026.08.29
↓ 385
统计检验与 APA 报告
@org-02qudk26/cn-statistical-analysis
面向工程师的统计分析技能,覆盖假设检验、回归、相关、贝叶斯分析、假设检查、效应量与 APA 报告。
数据分析
2026.08.30
↓ 385
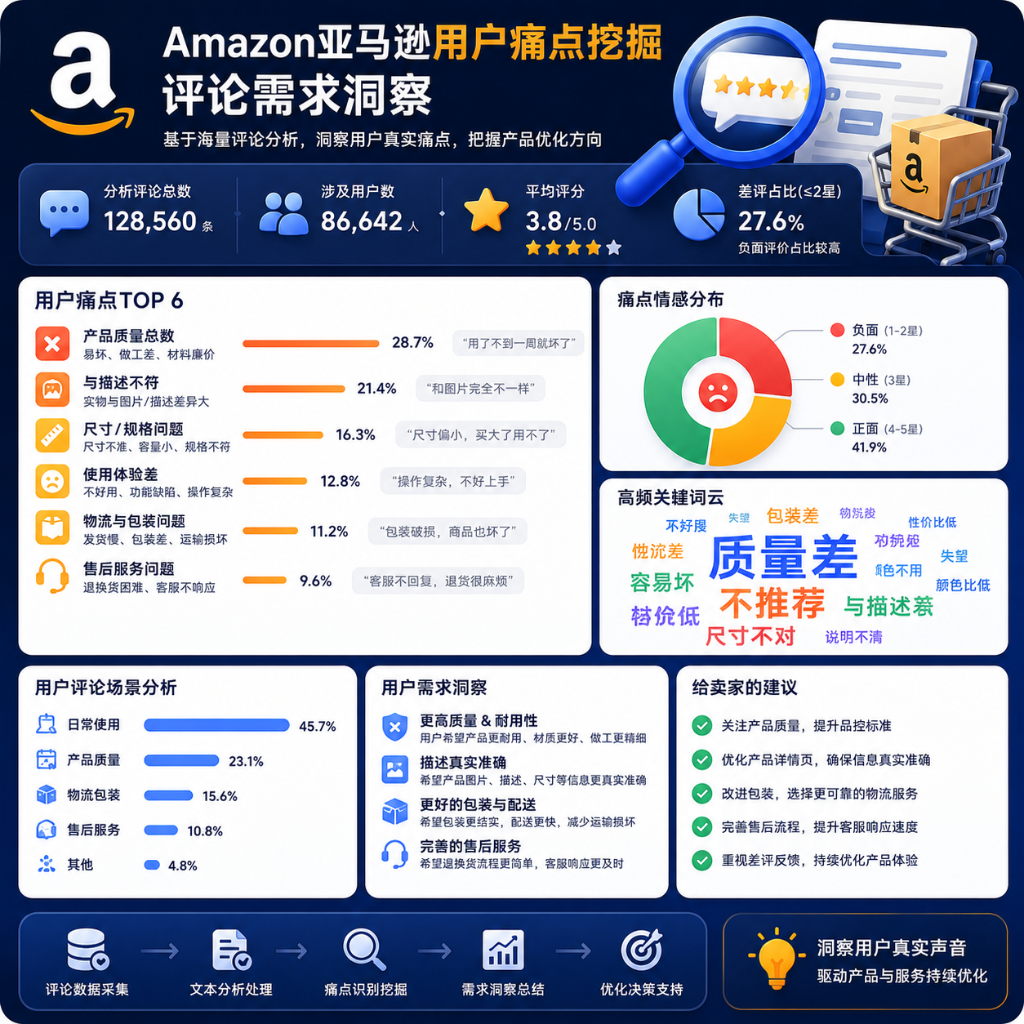
亚马逊用户痛点挖掘与评论需求洞察
@user_507a5056/pain-point
基于 ARI 评论样本分析 Amazon 用户痛点、VOC 报告、差评预警与竞品对比,辅助需求洞察和经营决策。
数据分析
2026.08.30
↓ 365