
公众号链接抓取
将以下提示词粘贴到你的 AI 对话框中:
请根据 https://skillhub.cn/install/skillhub.md,安装 @user_2b46b0cf/wx-gzh-link。
技能介绍
解决的问题
在运营复盘、竞品监控或链接归档时,常需要批量导出某个公众号的历史文章列表,而不是逐篇复制标题和 URL。这个技能面向单账号场景,只抓取 mp.weixin.qq.com 返回的列表元数据:title、digest、publish_time、link、cover_url 等,避免打开正文页面。
核心工作流
技能通过 scripts/fetch_gzh_links.py 调用公众号后台的列表接口,按每页 5 篇 的方式翻页。默认一次最多导出 100 篇;也可以用 --max-articles 5 做单页测试、--max-articles 0 做尽力全量抓取。重复运行时优先使用 --after-date、--since-date、--until-date 做日期范围或增量导出。输出默认是 utf-8-sig 编码的 CSV,便于 Excel 打开;加 --format json 可输出 JSON。
适用边界
使用前需要准备 mp.weixin.qq.com 的登录态、token 和 Cookie。如果接口返回 ret=200003、ret=200013 或会话失效,通常是凭据过期。技能不承诺一定能抓取全部历史文章,因为后台可能限流、停止返回或隐藏旧内容;它也不抓取正文,除非后续显式扩展。
使用场景
- 运营在竞品监控时,按日期范围导出某公众号近一周文章标题与链接,便于人工审阅。
- 数据工程师需要把指定公众号历史文章链接批量导出为 CSV,用于做阅读量趋势前的样本整理。
- 内容分析师每周回查某公众号是否发布新文章,用 after-date 只取上次抓取之后的链接列表。
- 研究者在整理中文资料时,用 fakeid 直接导出某账号若干篇标题、摘要、封面和文章 URL。
适合人员
- 运营:需要定期导出竞品公众号文章链接并核对发布时间。
- 数据分析师:要把公众号文章元数据整理成 CSV 后再做统计。
- 内容研究员:按日期范围抓取账号新文章,避免重复复制链接。
- 自动化工程师:在本地脚本中调用该技能导出指定 fakeid 的列表数据。
相关技能

基于五步框架搜索近期数据,快速分析公司需求、商业模式、护城河、生命周期与外部环境,并生成 HTML 可视化报告。

结合 DCF 估值、Livermore 趋势规则与市场情绪指标,生成 A 股/港股买入信号和完整分析报告。
面向工程师的统计分析技能,覆盖假设检验、回归、相关、贝叶斯分析、假设检查、效应量与 APA 报告。
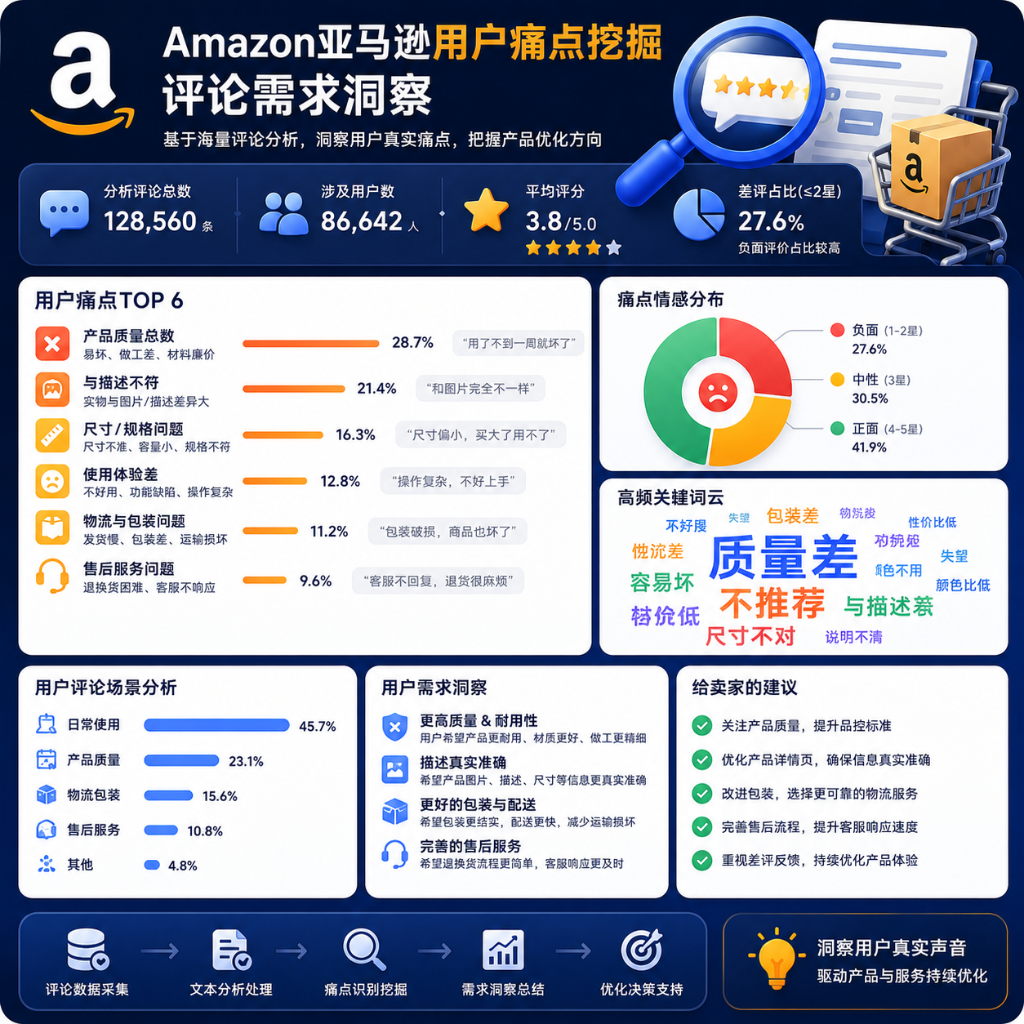
基于 ARI 评论样本分析 Amazon 用户痛点、VOC 报告、差评预警与竞品对比,辅助需求洞察和经营决策。