Firecrawl 网页数据抓取
将以下提示词粘贴到你的 AI 对话框中:
请根据 https://skillhub.cn/install/skillhub.md,安装 @user_b22a52ba/firecrawl。
技能介绍
要解决的问题
Firecrawl 面向的是 AI Agent 在处理网页时常见的几类摩擦:目标页面可能是带大量标签和脚本的 HTML,直接喂给模型既贵又噪声大;要找的信息又常常分散在搜索结果、子页面和整站文档里;静态抓取之外,还需要知道页面是否发生过变化。该技能把网页交互收敛为一组 API 调用,让 Agent 能先定位、再读取、最后把内容整理成适合推理或分析的格式。
技能如何工作
它围绕五个端点组织核心流程:
- Search:用
POST /v2/search在互联网中查找候选页面,并返回包含页面内容的结果列表。 - Scrape:对单个 URL 调用
POST /v2/scrape,输出Markdown、结构化数据或截图。 - Map:通过
POST /v2/map获取站点可抓取 URL,帮助判断网站结构。 - Crawl:用
POST /v2/crawl批量爬取整站,适合需要异步轮询的大规模抓取。 - Monitor:通过
POST /v2/monitor跟踪页面变化,并在变动时触发通知。
实际使用时,通常先用 Search 发现来源,再用 Scrape 深入提取;如果目标是整站资料,则先 Map 确认范围,再 Crawl。对于需要精确字段的页面,可以配合 extract 参数和 prompt 生成结构化数据。
适用边界
它适合需要干净网页文本、结构化字段和站点级抓取的任务,但不保证绕过所有反爬策略。调用会消耗 credits,Crawl 是异步操作,需要轮询结果;返回的 Markdown 可能包含目标网站使用的占位符或混淆内容。API Key 应通过环境变量传入,不宜硬编码在脚本里。
使用场景
- 排查竞品官网改版时,用 Monitor 跟踪目标页面并收到变更提醒。
- 整理行业报告时,先 Search 定位来源,再 Scrape 提取正文 Markdown。
- 需要汇总站点资料时,用 Map 确认 URL 范围后再 Crawl 整站。
- 从产品详情页提取价格与规格时,使用 extract 生成结构化字段。
适合人员
- 构建 AI Agent 的工程师,需要把网页转成 Markdown 或结构化数据。
- 做竞品情报的分析人员,需要监控目标页面并发现内容变化。
- 整理站点文档的研究人员,需要 Map 和 Crawl 批量获取可用 URL 与正文。
- 调用外部数据源的后端工程师,需要按 Bearer API Key 请求 Firecrawl 端点。
相关技能
统计检验与 APA 报告
@org-02qudk26/cn-statistical-analysis
面向工程师的统计分析技能,覆盖假设检验、回归、相关、贝叶斯分析、假设检查、效应量与 APA 报告。
数据分析
2026.08.30
↓ 385
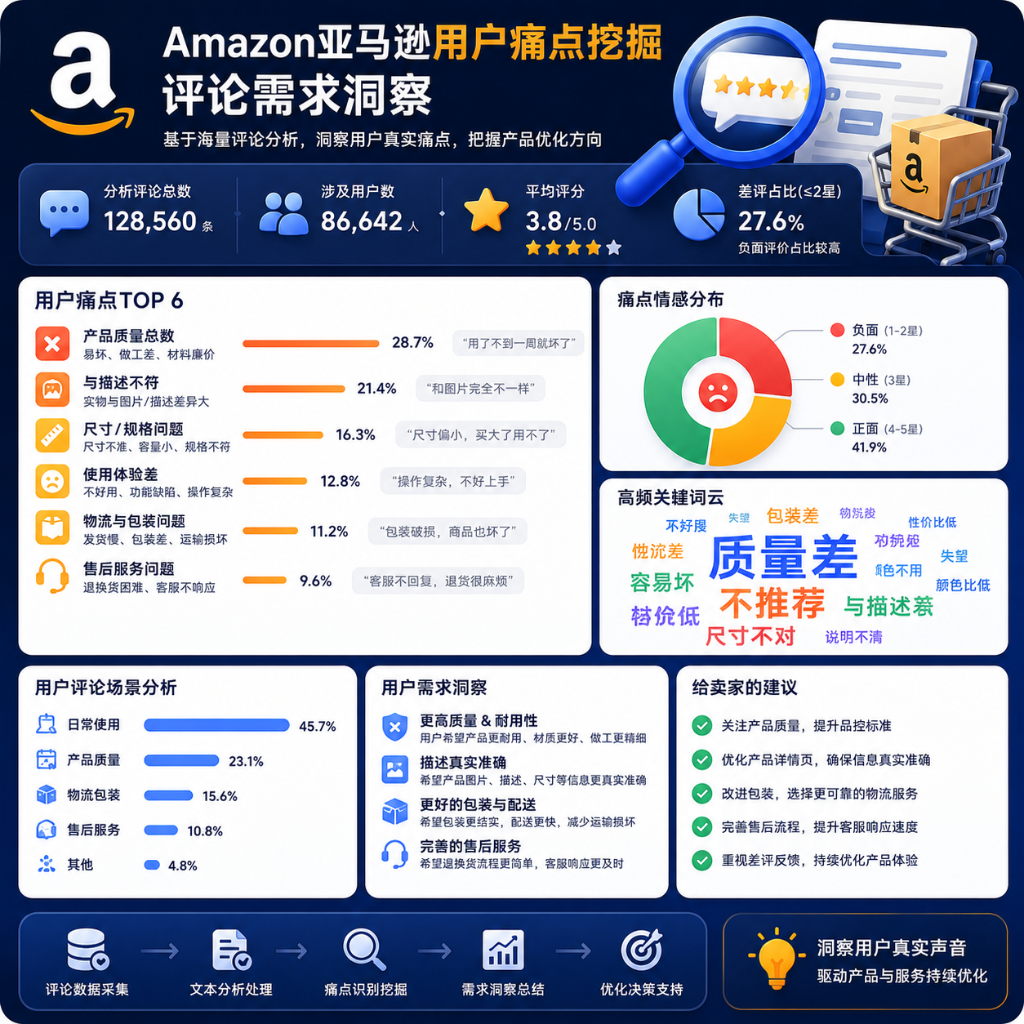
亚马逊用户痛点挖掘与评论需求洞察
@user_507a5056/pain-point
基于 ARI 评论样本分析 Amazon 用户痛点、VOC 报告、差评预警与竞品对比,辅助需求洞察和经营决策。
数据分析
2026.08.30
↓ 365

百度热搜榜 TOP 10
@user_512254e3/top-baidu-hot
优先使用 web_fetch 抓取百度热搜,校验当天数据,失败时自动降级到浏览器,并输出 TOP 10 排名标题。
数据分析
2026.08.29
↓ 389

A股政策与交易机会日报
@user_1c63be68/a-stock-daily-report-plus
每晚自动搜集指数、政策与资金数据,按固定模板生成约1200字的A股政策与交易机会日报,并标注受益板块、驱动事件和涨跌方向。
数据分析
2026.08.29
↓ 389